TL;DR
Deep Delta Learning은 $\beta$ gate에 의해 3가지 연산으로 residual connection을 강화했습니다.
$\beta \rightarrow 0$의 경우 layer를 통과한 값을 무시하고 입력을 출력으로 그대로 보내며 (identity)
$\beta \rightarrow 1$일 때에는 $k$에 따라 원본 값을 삭제하고, $v$값을 해당 부분에 합하게 됩니다. 이때 $v$는 mlp와 같이 해당 block에서 연산하는 연산계층을 의미합니다.
$\beta \rightarrow 2$일때에는 $k$에 따라 원본 값을 반사시키고, 해당 위치를 $2v$ 만큼 변화한 값을 더해줍니다.
이를 통해 기존 ResBlock에서는 할수 없었던 기하학적 변환을 일반화하고 재정렬하는 능력을 갖출수 있습니다.
- Paper: Deep Delta Learning
- Code: https://github.com/yifanzhang-pro/deep-delta-learning
- Paper from
ArXiv_2026
🔁 Limmitation of Residual Connection
Residual Connection은 identity를 지속적으로 유지하여 깊은 네트워크에서도 안정적으로 학습이 가능하게 만든 방법 중 하나입니다.
그러나 다음과 같은 한계점이 존재합니다:
- 지속적인 shortcut connection은 inductive bias를 불러옴 (불필요한 정보도 계속해서 누적)
- 고정된 경로 및 연산 때문에 representation이 제한적
최근 이러한 한계를 보완하기 위해 유연한 방법론들이 제안되고 있습니다.
Deep Delta Learning(DDL)은 이같은 한계를 보완하기 위한 방법 중 하나로 다음을 제안하였습니다.
- Delta Residual Block
- Delta Operator
𝜟 The Delta Residual Block
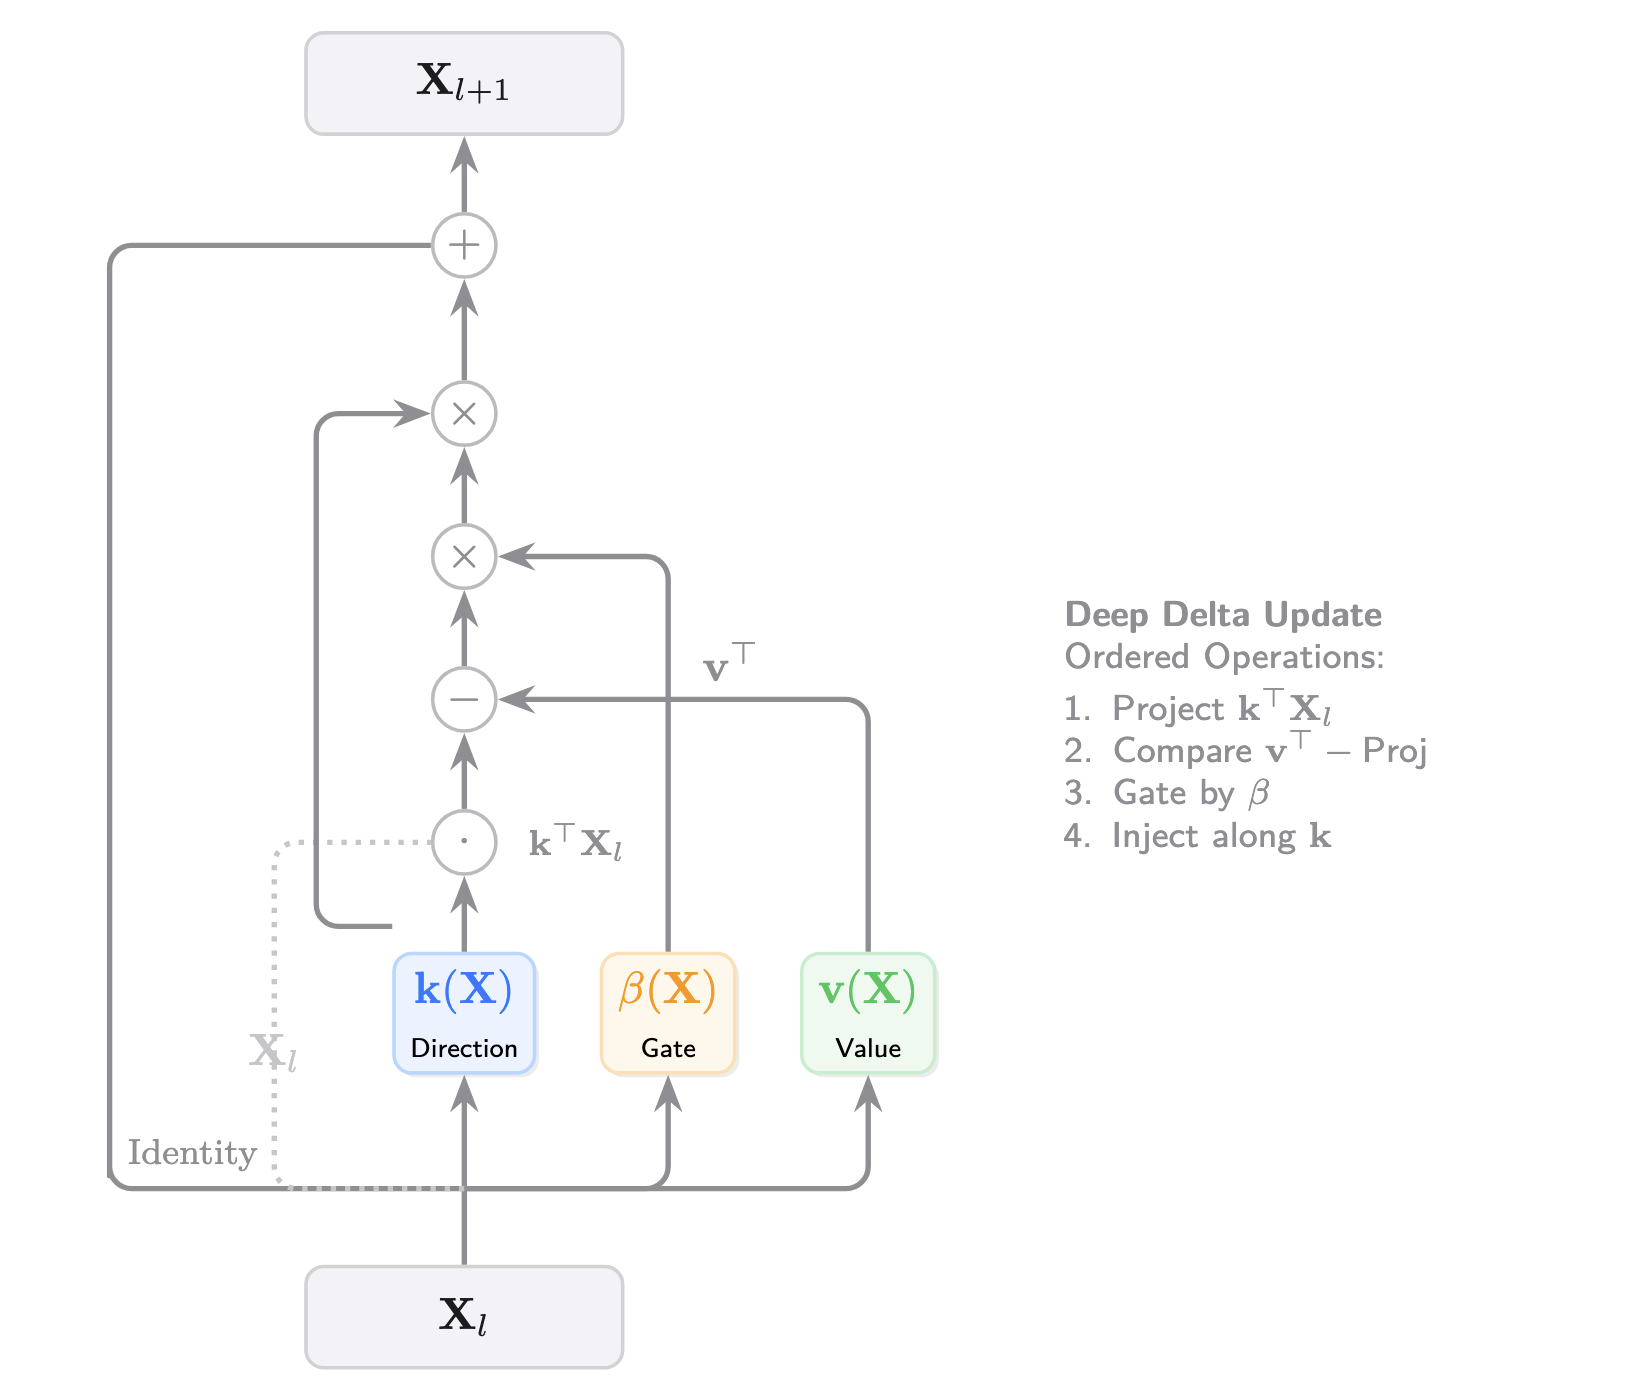
표준 ResNet은 $X_{l+1}=X_l+F(X_l)$으로 작동하지만, DDL은 Delta Operator($A(X)$)를 사용합니다. 가장 핵심인 Delta Residual(Delta-Res) block은 다음과 같이 정의됩니다.
hidden state $\text{X} \in \mathbb{R}^{d\times d_v}$ 일때, ($d$는 벡터의 크기, $d_v$는 병렬적인 값의 크기, 즉 attention head 수 정도로 이해하시면 됩니다.) $v \in \mathbb{R}^{d_v}$, $k \in \mathbb{R}^{d}$, $\beta \in \mathbb{R}$의 크기를 가집니다.
여기서 $A(X)$는 상태 $X$의 feature 차원에 작용하는 변환 행렬로 다음과 같이 정의됩니다.
$A(X)$는 기존 ResNet의 표준적인 덧셈 연산을 Householder reflection을 일반화한 수식으로 대체한 것입니다.
해당 수식에서 $k(X)$는 단위벡터이기 때문에 $k(X)$의 내적인 $k(X)^{\sf T}k(X)=1$이 됩니다. $\epsilon\rightarrow0$이므로, 해당 수식을 간소화 하면 다음과 같습니다.
해당 수식을 $X_{l+1}$에 대입하면 다음과 같이 rank-1 Delta form으로 정리할 수 있습니다.
해당 수식을 통해 알 수 있는것은 결국 $\beta$에 따라 각 $k^{\sf T}X$와 $v^{\sf T}$에 대한 gate역할을 할 수 있다는 것입니다. 예를 들어 $\beta=0$ 인경우 $X_{l+1}=X_l$로 항등식이 됩니다. (layer를 건너뛰게 됩니다.)
각각의 component를 간단히 소개하자면 다음과 같습니다.
- $k(X)\in\mathbb{R}^d$ (Direction): 선택적으로 값을 수정하기위한 방향 (쉽게 말해 어떤 부분을 수정할 것인지 고르는 역할)
- $\beta(X)\in\mathbb{R}$ (Gate): 얼마나 강하게 수정할 것인지, 어떤식으로 수정할 것인지를 고르는 역할 (지우고 새로쓸지, 반전시킬지, 그대로 납둘지)
- $v(X)\in\mathbb{R}^{d_{v}}$ (Value): 무엇을 쓸것인지에 대한 값, 해당 layer에서 생성된 특징 값을 의미 (attention, ffn 등)
수식이 복잡한데, 실제 작동방식을 정리해보겠습니다.
🤔 Unification of Geometric Operations
$\beta$ 는 [0, 2] 사이의 값을 가지는 learable gate입니다. 다음과 같은 수식을 통해 값을 산출합니다.
$\mathcal{G}$는 pooling, convolution등의 flatten operation입니다. 즉 값을 압축해서 하나의 scalar를 만들고, 2 ⨉ sigmoid를 통해 0~2사이의 값으로 만듭니다. $\beta$가 0, 1, 2에 각각 가까울때, Delta Residual block은 단순한 덧셈 연산이 아닌 다양한 operation으로 변화하게 됩니다.
Identity Mapping ($\beta(X)\rightarrow 0$)
$\beta \rightarrow 0$일경우, 방금 설명과 같이 $X_{l+1} \approx X_l$이 됩니다. 즉 입력과 출력이 같은 항등식이 되며, 해당 layer를 skip하고 원본 신호를 보존합니다.
Orthogonal Proejction ($\beta(X)\rightarrow1$)
$\beta \rightarrow 1$일 경우, $A(X)\approx I-k(X)k(X)^{\sf T}$가 됩니다.
이때 $k(X)$에 대한 eigenvalue(고윳값)은 0이됩니다.
- 고윳값? : 행렬 $A$에 벡터 $k$를 곱했을때, $\lambda k$가 된다면 ($\lambda$는 scalar로, 즉 $Ak$는 $k$의 $\lambda$배가 되는겁니다.)
정리 및 증명
이때 $\beta$는 scalar이므로 해당 수식의 $k(X)$에 대한 eigenvalue는 $1-\beta$이고 $\beta\approx 1$일때 eigenvalue가 0에 가까워지고, $k$ 방향의 정보가 0이되는 singular matrix(특이 행렬)라는 것입니다.
간단히 말해 $A(X)=X-k(X)k(X)^{\sf T}$는 $X$에서 $k(X)k(X)^{\sf T}$를 빼어냈기 때문에 $A(X)$의 결과는 $k$ 방향의 성분이 0이 됩니다.
전체 수식을 보면 $A(X)$는 정보를 지우는 부분을 담당하고, $v$는 정보를 추가하는 부분을 담당하게 됩니다.
여기서 $k$에 의해 지워진 부분을 $v$로 연산된 값으로 채우게 됩니다. $v(X)$는 다양한 연산자에 대응되므로 (MLP 등)
해석하자면 입력에서 $k$ 벡터를 통해 쓸모 없는 위치의 값은 지우고, 연산된 값으로 업데이트하며, 나머지 부분들은 입력을 동일하게 가져갑니다. 즉 정말 필요한 부분은 선택적으로 남기고, 연산을 통해 보정해야 할 부분만 보정하는 것입니다.
다만 실제로 $\beta=1$에 정확히 맞아야 완전히 값을 지우는것이고, $\beta \rightarrow 1$ 일때에서는 $k$ 방향을 지운다 라고 표현할 수 있습니다.
이때 $v$는 $X\in\mathbb{R}^{d\times d_v}$에서 $d_v$로 projection합니다. 그렇다는 것은 모든 $d$차원에 대해 $k$와 수직인 값들만 보존되고, 각 head별 $v(X)$의 값대로 특징맵이 수정되게 됩니다.
–> $k$차원과 $v$차원에 대한 1-rank 연산을 통해 수정할 부분, 남길부분 등을 결정하고 연산하는 것입니다.
e.g., $k=\begin{bmatrix} 1\\\\0 \end{bmatrix}$, $X=\begin{bmatrix}2\\\\3\end{bmatrix}$ 일때 $\beta=1$일 경우 ($k$는 단위 벡터)
즉 $A(X)X$의 결과는
Full reflection ($\beta(X) \rightarrow 2$)
$\beta \rightarrow 2$ 일 때, $A(X)=I-2k(X)k(X)^{\sf T}$가 됩니다. 즉 이번에는 고윳값 $1-\beta=-1$이 됩니다.
위의 수식과 마찬가지로 풀어보자면 $k$ 방향에 대한 값이 크기는 같고 방향이 반대(-1)이 됩니다.
e.g., $k=\begin{bmatrix} 1\\\\0 \end{bmatrix}$, $X=\begin{bmatrix}2\\\\3\end{bmatrix}$ 일때 $\beta=2$일 경우 ($k$는 단위 벡터)
- Delta operator $A(X)$ 연산
즉 $A(X)X$의 결과는
결론적으로 $k$ 방향에 대한 성분 2가 -2로 반사된 것을 확인할 수 있습니다.
$\beta \rightarrow 1$과 마찬가지로 $2k(X)v(X)^{\top}$은 반사된 값에 대해 보정합니다.
추가로 Appendix에서는 Transformer 기반 모델에서 사용할때 구현 방법에 대한 설계방법이 정리되어 있습니다.