TL;DR
최근 alphaxiv에서 가장 hype 받는 논문 중 하나여서 가져옴
[[Evolution Strategies]] (ES)라는 학습 방식은 forward pass만으로 학습 가능한 강력한 알고리즘인데, 실질적으로 LLM과 같은 huge model에는 적용이 불가능한 limitation을 해결하고자 제안.
- Code: https://github.com/ESHyperscale/HyperscaleES
- Paper: Evolution Strategies at the Hyperscale
- Project page: https://eshyperscale.github.io/
- Paper from #Arxiv_2025
🧬 Evolution Strategies?
경사하강(gradient) 없이 모델을 학습할 수 있는 최적화 알고리즘
“생물의 진화원리와 유사하게 파라미터를 최적화 하는 방법”
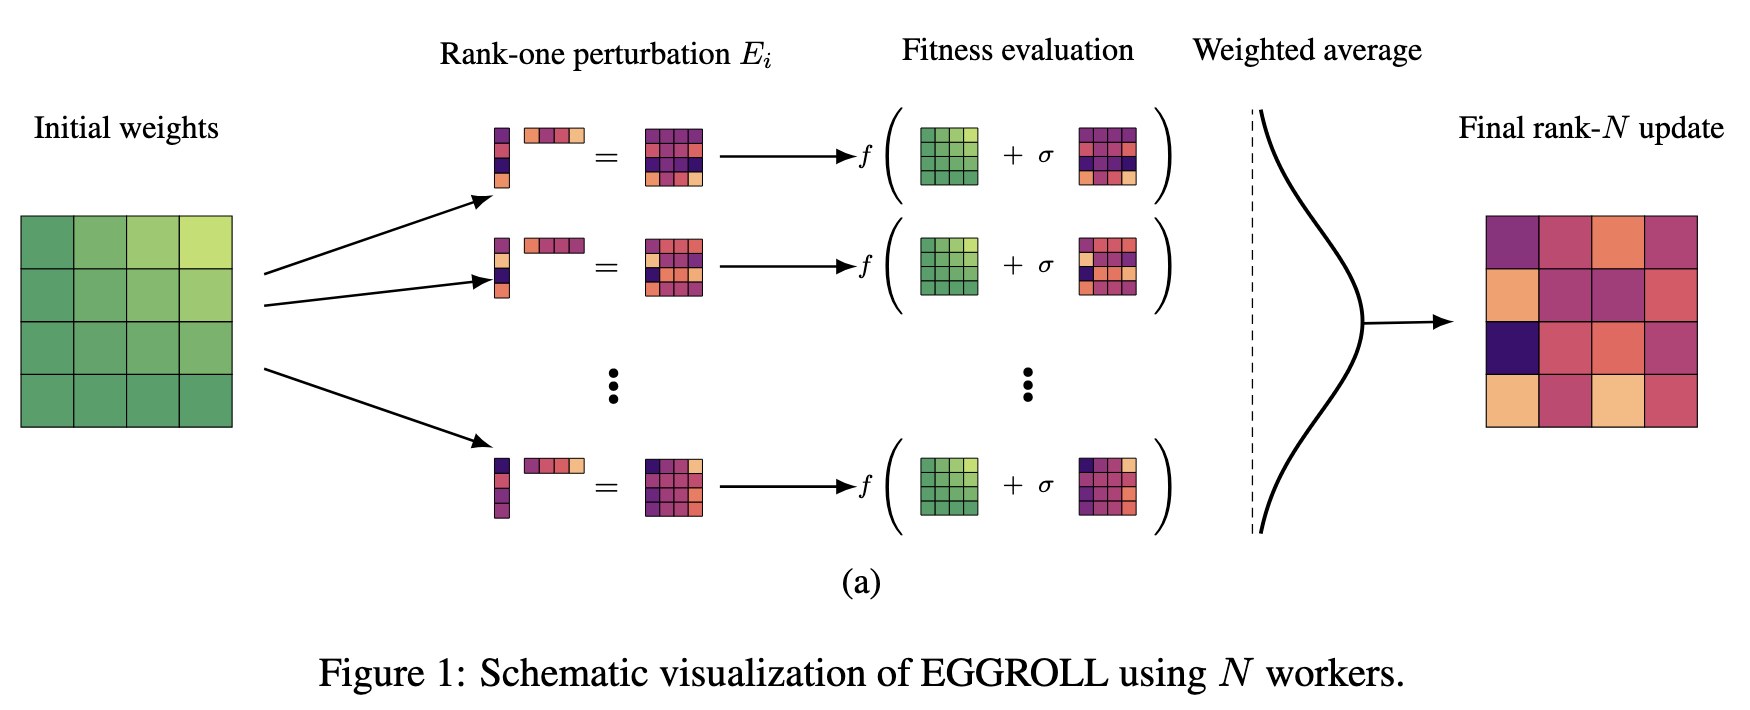
parameter perturbation
Initial parameter $\theta$ (parent)에 무작위 $\epsilon$(perturbation)을 주어 여러 개의 perturbed offspring 생성
모델의 모든 파라미터에 대해 총 i번 각각 noise를 추가하고 forward pass.
성능 평가 (fitness)
loss를 계산하듯 성능을 측정 ($f(\theta_i)$)
e.g., RL: episode reward / DL: 정답 여부, 성능 지표 등
성능이 높은 perturbation 방향으로 parameter update
가장 성능이 높았던 perturbation일 수록 더 강하게 반영하여 parameter를 update
기존 gradient 기반 방법과 비교
| 비교 | Gradient Descent(역전파) | Evolution Starategies |
|---|---|---|
| 미분 | 미분 필요 | 미분 불필요 |
| noisy/불연속 환경 | 취약 | 강함 |
| 병렬화 | 제한적 | 매우 병렬적 |
| 연산 | 미분 + backprop | forward 반복 |
수학적으로 보자면 다음과 같이 gradient free면서도 근사적으로 gradient 계산과 유사한 방식
LLM 등에서 backprop이 없어 메모리 부담이 적고, integer-only의 새로운 구조도 학습이 가능하며, 병렬 연산에 최적화 되어 있어 효율성이 매우 높음. (GRPO 보다도)
🐣 EGGROLL
핵심 아이디어: Full-rank noise 대신 Low-rank matrix로 대체하여 더 효율적 연산 가능
기존 ES의 수식이 아래와 같을때:
(이전 수식의 $\epsilon_i=E_i$ –> $m \times n$ 크기의 full-rank matrix)
업데이트는 위 수식이랑 동일하지만, 기존에는 $E_i\in\mathbb{R}^{m\times n}$으로 생성했다면 (full-rank gaussian)
EGGROLL은 다음으로 대체:
Novelty 1. Efficiency
full-rank matrix의 경우 생성 및 저장 비용이 매우 높음 ($O(mn)$)
forward pass 비용도 population size N배 증가 (기존 supervised learning forward 한번에 비해)
EGGROLL의 경우 생성/저장 비용 및 forward 비용을 근본적으로 낮출 수 있음.
–> 중요한 부분중 하나로 pertubation을 저장하는 비용을 매우 낮출수 있음.
특히 dedicated counter-based RNG라는 로직을 구성해 A,B를 on-the-fly로 구성
기존에는 noise matrix를 forward에서 한번, parameter update 시에 한번 사용해야 하므로 이걸 저장할 메모리가 필요한데, LLM 같이 파라미터가 billion 이상되면, 너무 커서 현실적으로 저장이 불가능함
이걸 저장하는 방식이 아니라 sampling 하는 방식으로 변경 (매우 효율적)
Novelty 2. 매우 빠르게 full-rank ES gradient에 수렴 가능
r=1부터 이미 상당히 좋은 품질로 학습되고 rank가 높을수록 매우 빠르게 full-rank ES에 수렴 가능함. –> 이건 수학적으로 증명이 되어 있는데, (A,B가 대칭 분포로부터 sampling된다던지.. ) 어려우니까 자세한건 논문 참고.
Novelty 3. GPU batch 처리
기존 ES: forward pass를 N번 필요로 함 (polulation size N이 커질수록 비용 증가, 느림)
EGGROLL: LoRA style로 pertubation을 batch 처리하여 속도를 매우 빠르게 증가시킴
기존 OpenES 대비 100~200x
정리
즉 기존에는 너무 느린 ES 대비 훨씬 빠르고 효율적이면서 성능도 유사하게 가져가므로 billion 급 파라미터를 가진 LLM 같은 모델에도 적용 가능함.
| 항목 | ES | EGGROLL |
|---|---|---|
| noise | full-rank($m\times n$) | low-rank($A\cdot B^T$) |
| cost | $O(mn)$ | $O(r(m+n))$ |
| population scaling | 거의 불가능 | 10만~26만까지 가능 |
| GPU 사용 | 비효율적 | batched LoRA style로 매우 효율적 |
| memory | noise 저장, 비효율적 | A,B만 sampling, (저장 x) |