TL;DR
대부분의 최신 비전 모델은 이미지를 patch 단위로 처리할때, 각 patch 간의 상관관계를 균등하게 취급하거나 무작위 순서로 학습함 (MIM, MAE 등)
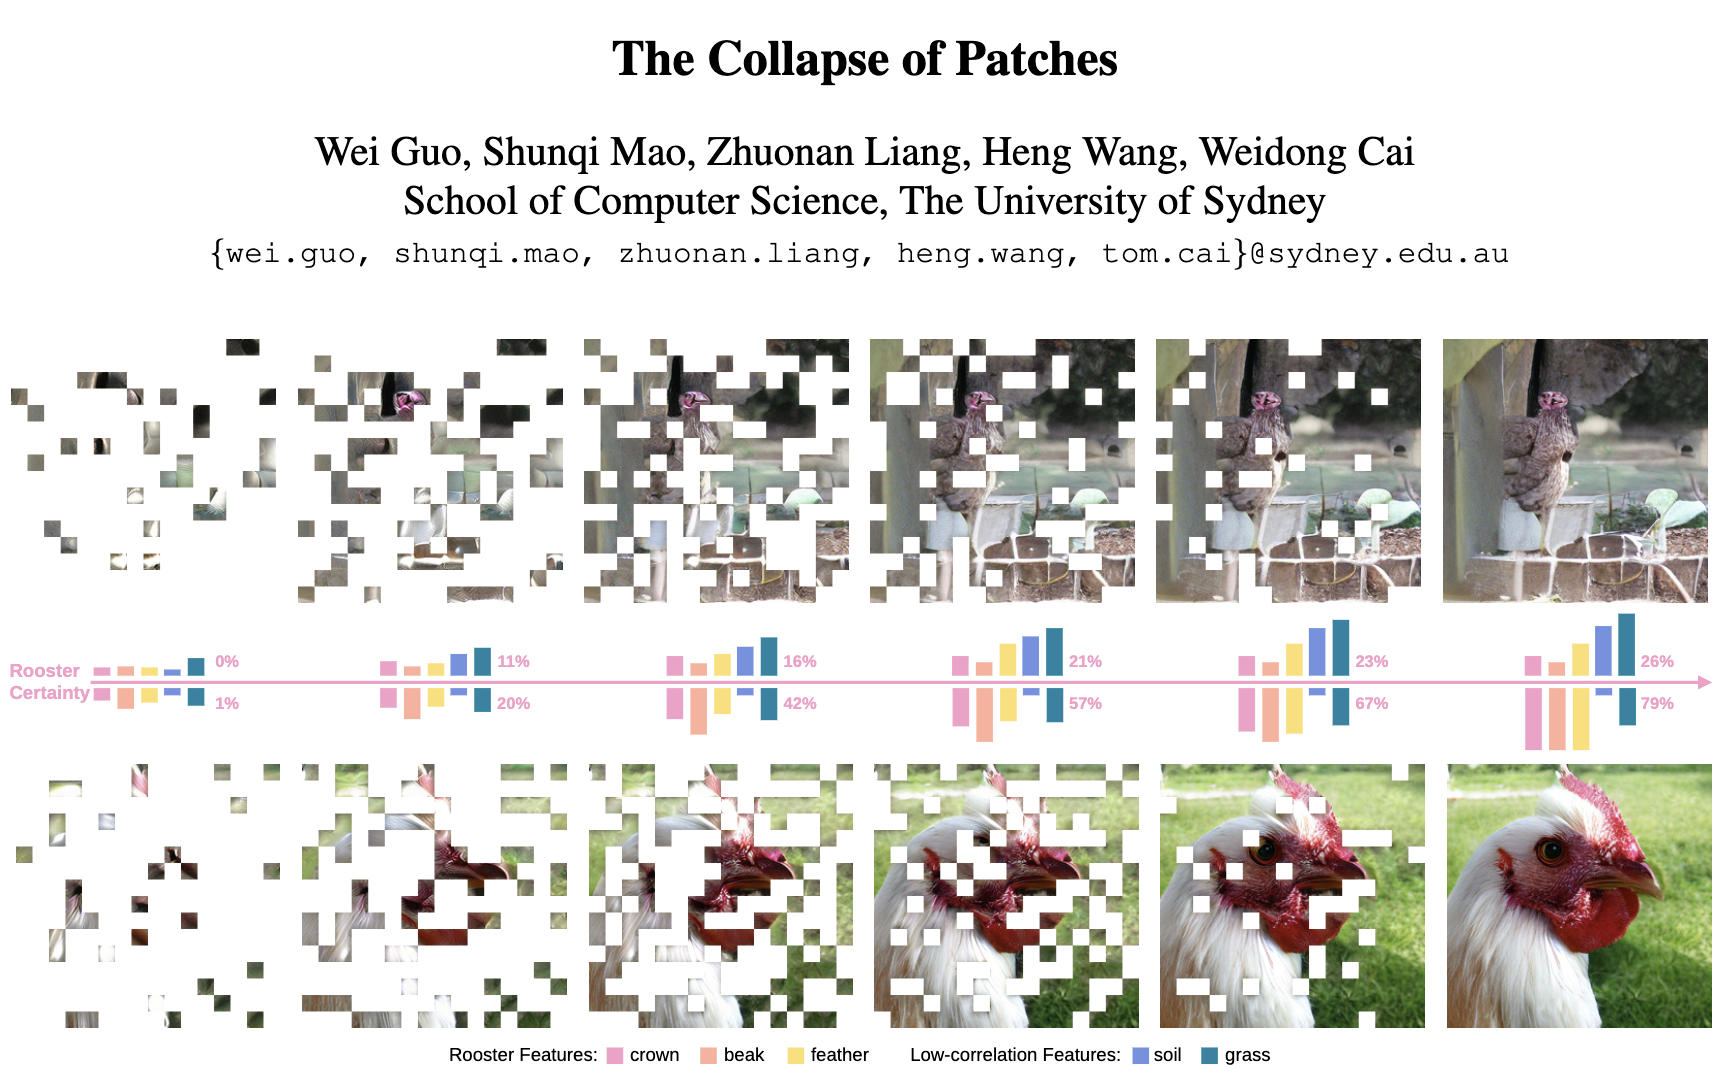
그러나 이미지의 특정 중요 부분(e.g., 닭의 부리)을 먼저 본다면 다른 부분을 먼저 보는 것보다 (e.g., 잔디 같은 배경) 남은 이미지의 불확실성을 더 크게 줄여준다가 핵심.
따라서 이미지를 구성하는 최적의 순서를 찾아내서 이미지 생성과 분류의 성능을 높이는 방법을 제안
- Code: https://github.com/wguo-ai/CoP
- Paper: The Collapse of Patches
- Paper from
Arxiv_2025
💥 Patch Collapse?
이미지를 N개의 patch embedding 집합을 ${e_n }^N$으로 표현할 때 목표: 이미지의 불확실성(Entropy)를 가장 빠르게 낮추는 patch의 최적 순서(rank function, $R$)를 찾는것
$$ H_c = \sum^N_{i=1}H\bigg[ P\big(e_n|{ e_i;R(e_i)>R(e_n) }^N_{i \neq n} \big) \bigg] $$
$H$는 분포의 entropy를 의미 즉 중요한 patch를 먼저 관측할때, 남은 patch $e_n$의 불확실성의 합 $H_c$이 최소화되도록 하는 순서 $R$을 찾는것이 목표
𝌰 Collapse Masked Autoencoder (CoMAE)
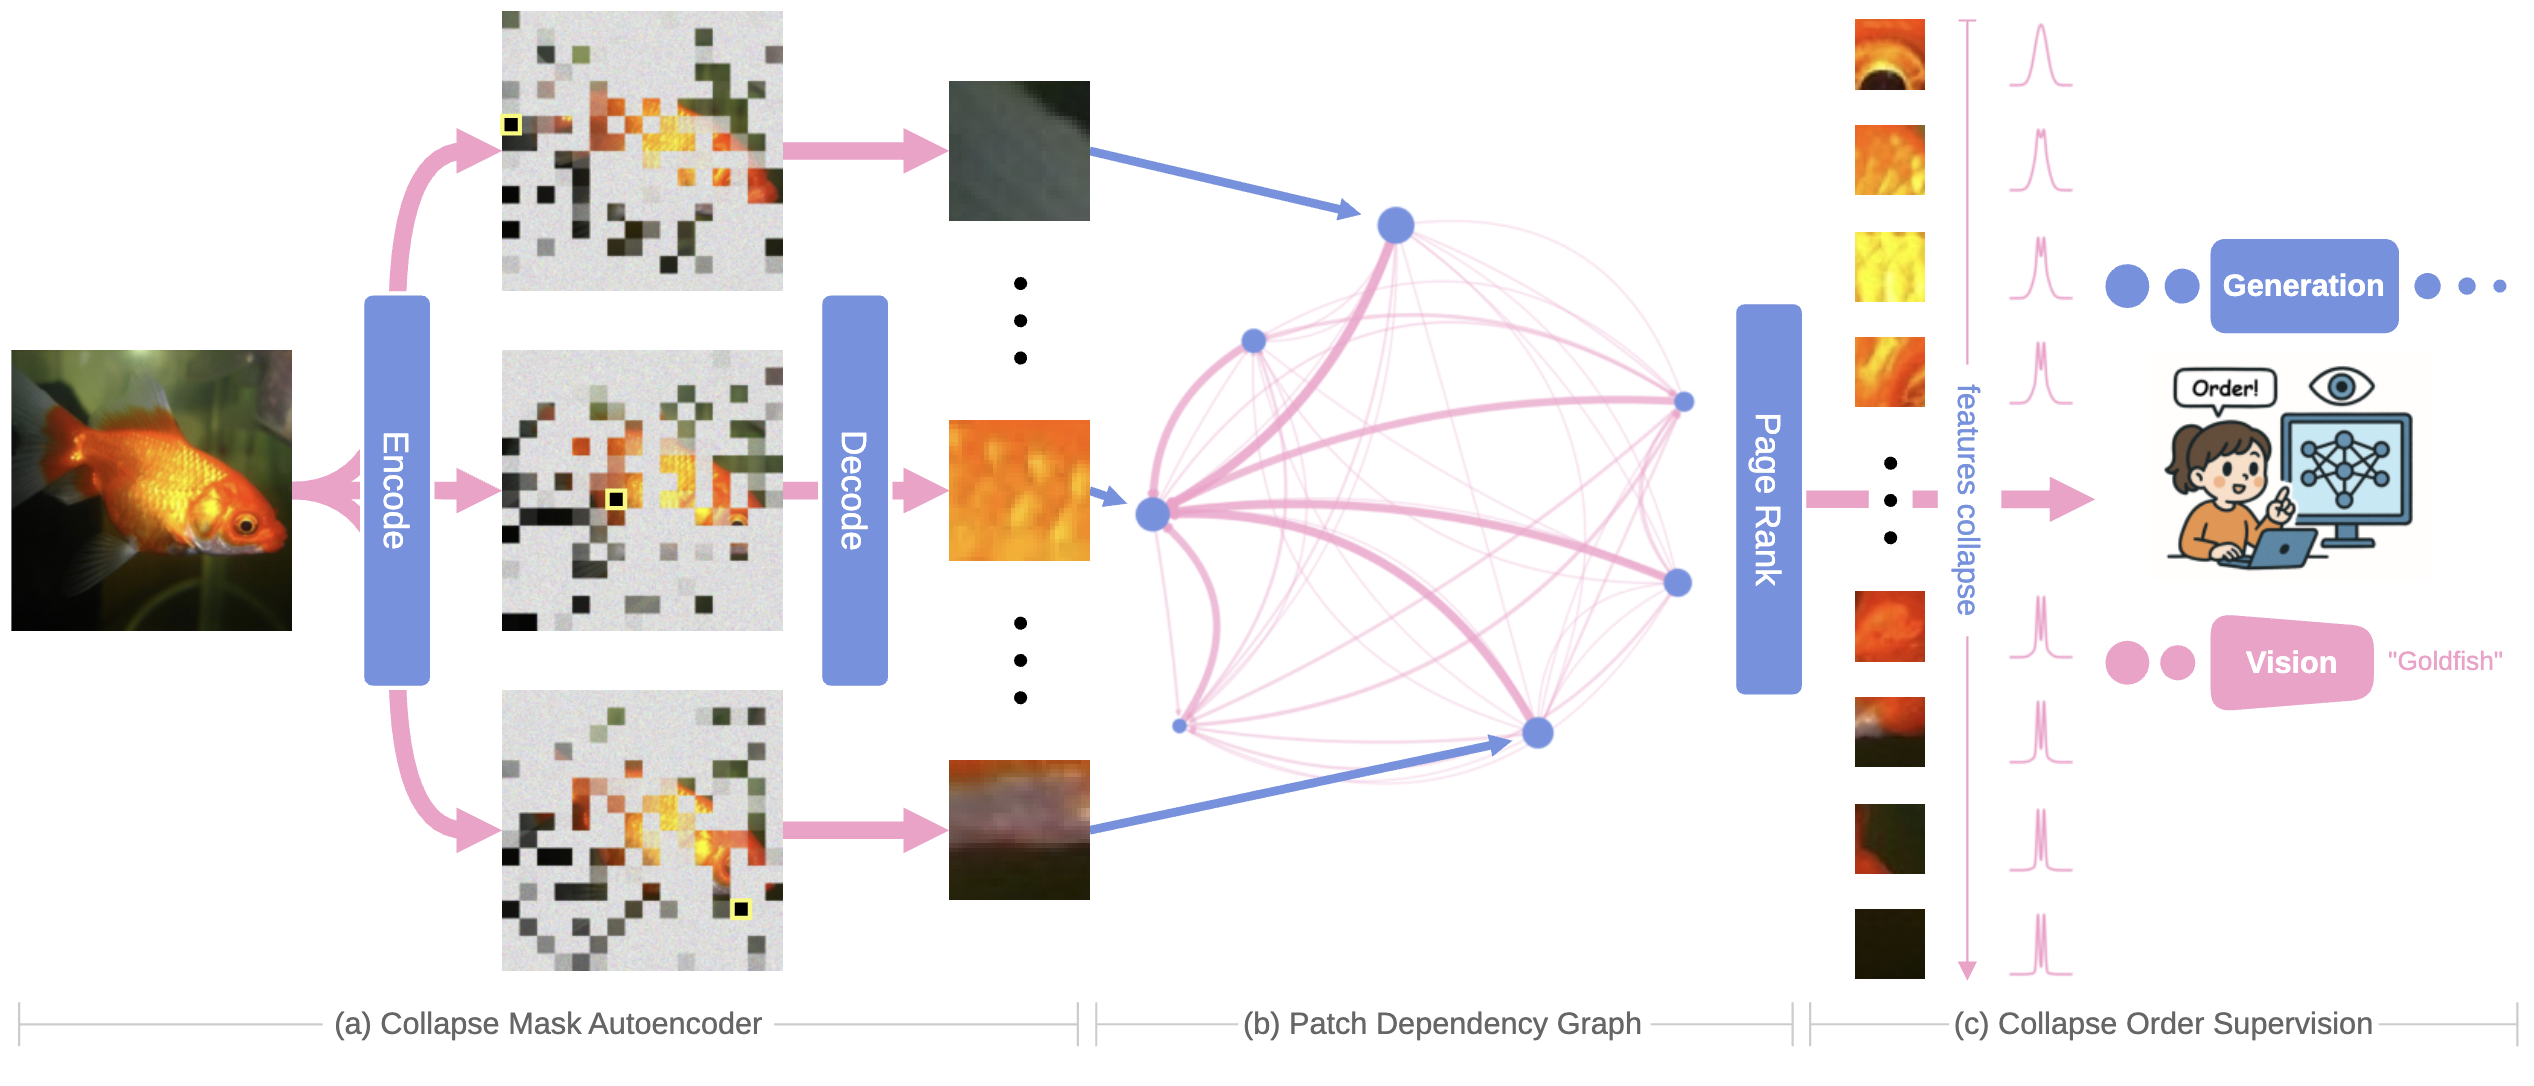
CoMAE: 특정 patch를 복원하기 위해 다른 patch들 중 어떤 것이 가장 필요한지 학습
Encoder (중요도 예측):
- 인코더 $f$는 target patch $n$을 제외한 나머지 patch를 입력받아, 각 patch가 target patch 복원에 얼마나 기여하는지를 나타내는 가중치 벡터 $w$($w \in [0,1]$)를 예측
- $q_n$: 복원할 target patch의 Positional Encoding
$$ w_n=f({ e_i }^N_{i \neq n};q_n) $$
Masking (noise injection):
- 단순히 patch를 가리는게 아니라 예측된 가중치 $w_n$에 따라 noise를 주입. 중요하지 않은 patch일 수록 noise를 많이 섞어 정보를 지워버림.
- $e^m_i$: masking(noise injection)된 patch
- $\alpha_i$: 가중치 $w$가 1에 가까우면(중요) $\alpha$도 1이 되어 원본 $e_i$가 보존되고, $w$가 0이되면 noise만 남게 됨
$$ e^m_i=\alpha_ie_i+(1-\alpha_i)\mathcal{N}(0,I), \ i \neq n $$ $$ \alpha_i= \exp\bigg(-\frac{(1-w_n^i)^2}{2\sigma^2}\bigg) $$
Decoder (복원):
- 디코더 $g$는 노이즈가 섞인 patch들($e^m_i$)을 보고 target patch $e_n^{*}$을 복원
$$ e_n^{*}=g\big( { e^m_i }^N_{i \neq n} ; q_n \big) $$
Loss function:
- Reconstruction loss($\mathcal{L}_r$): l1 loss
- Contrastive regularization loss($\mathcal{L}_{c}$): patch마다 의존하는 patch 조합이 다양해지도록 유도하여 가중치 w가 0이나 1로 명확하게 갈리도록하는 보조 함수 (Polarization)
🥇 Patch Ranking (PageRank)
CoMAE를 통해 모든 patch 쌍에 대한 의존성(가중치 $w$)를 구하면, 이를 $N \times N$ 크기의 인접 행렬 $A$로 만들수 있음 ($A_{ij}=w_{ij}$) 일종의 patch 의존성 graph.
- 해당 graph에 PageRank 알고리즘 적용
- PageRank는 구글 등 검색엔진에서 웹페이지 우선도를 결정하는 알고리즘
- PageRank 점수가 높은 patch는 다른 patch에 큰 영향을 주는 independent하고 중요한 patch.
- 점수대로 patch를 나열한 것이 Collapse order(붕괴 순서) –> 최적의 순서 $R$
🖼️ Collapsed Mask Autoregressive Model (CMAR)
- 기존 Auto Regressive Model(MAR)은 이미지 생성시 랜덤 순서로 patch를 생성함
- CMAR은 Collapse Order가 높은 patch부터 순서대로 생성하도록 학습
- MAR(backbone)과 비교해 FID 향상
- 여기서 알아야 하는건 CoMAE를 함께 사용한다는것, 따로 distillation 하거나 collapse order를 학습하지는 않음.
📚 Collapsed Vision Transformer (CViT)
- 일반적인 ViT는 전체 이미지를 한번에 관측
- 따라서 CViT는 Collapse order가 낮은 patch를 입력에서 제거 (drop)하고 학습함
- 22%에 해당하는 중요 patch만 보여줘도 높은 정확도를 유지할 수 있음.
- 마찬가지로 CoMAE를 함께 사용. 대신 VAE는 일반적인 Transformer 모델에 비해 훨씬 lightweight하니 여전히 효율적이라고 하는듯 (embedding space만 해도 64 vs over 768이니..)