TL;DR
LLaVA의 corresponding인 위스콘신의 이용재 교수님의 연구실에서 제안된 논문으로 visual representation을 인간과 유사한 뱡항으로 정렬 할 수 있도록 제시
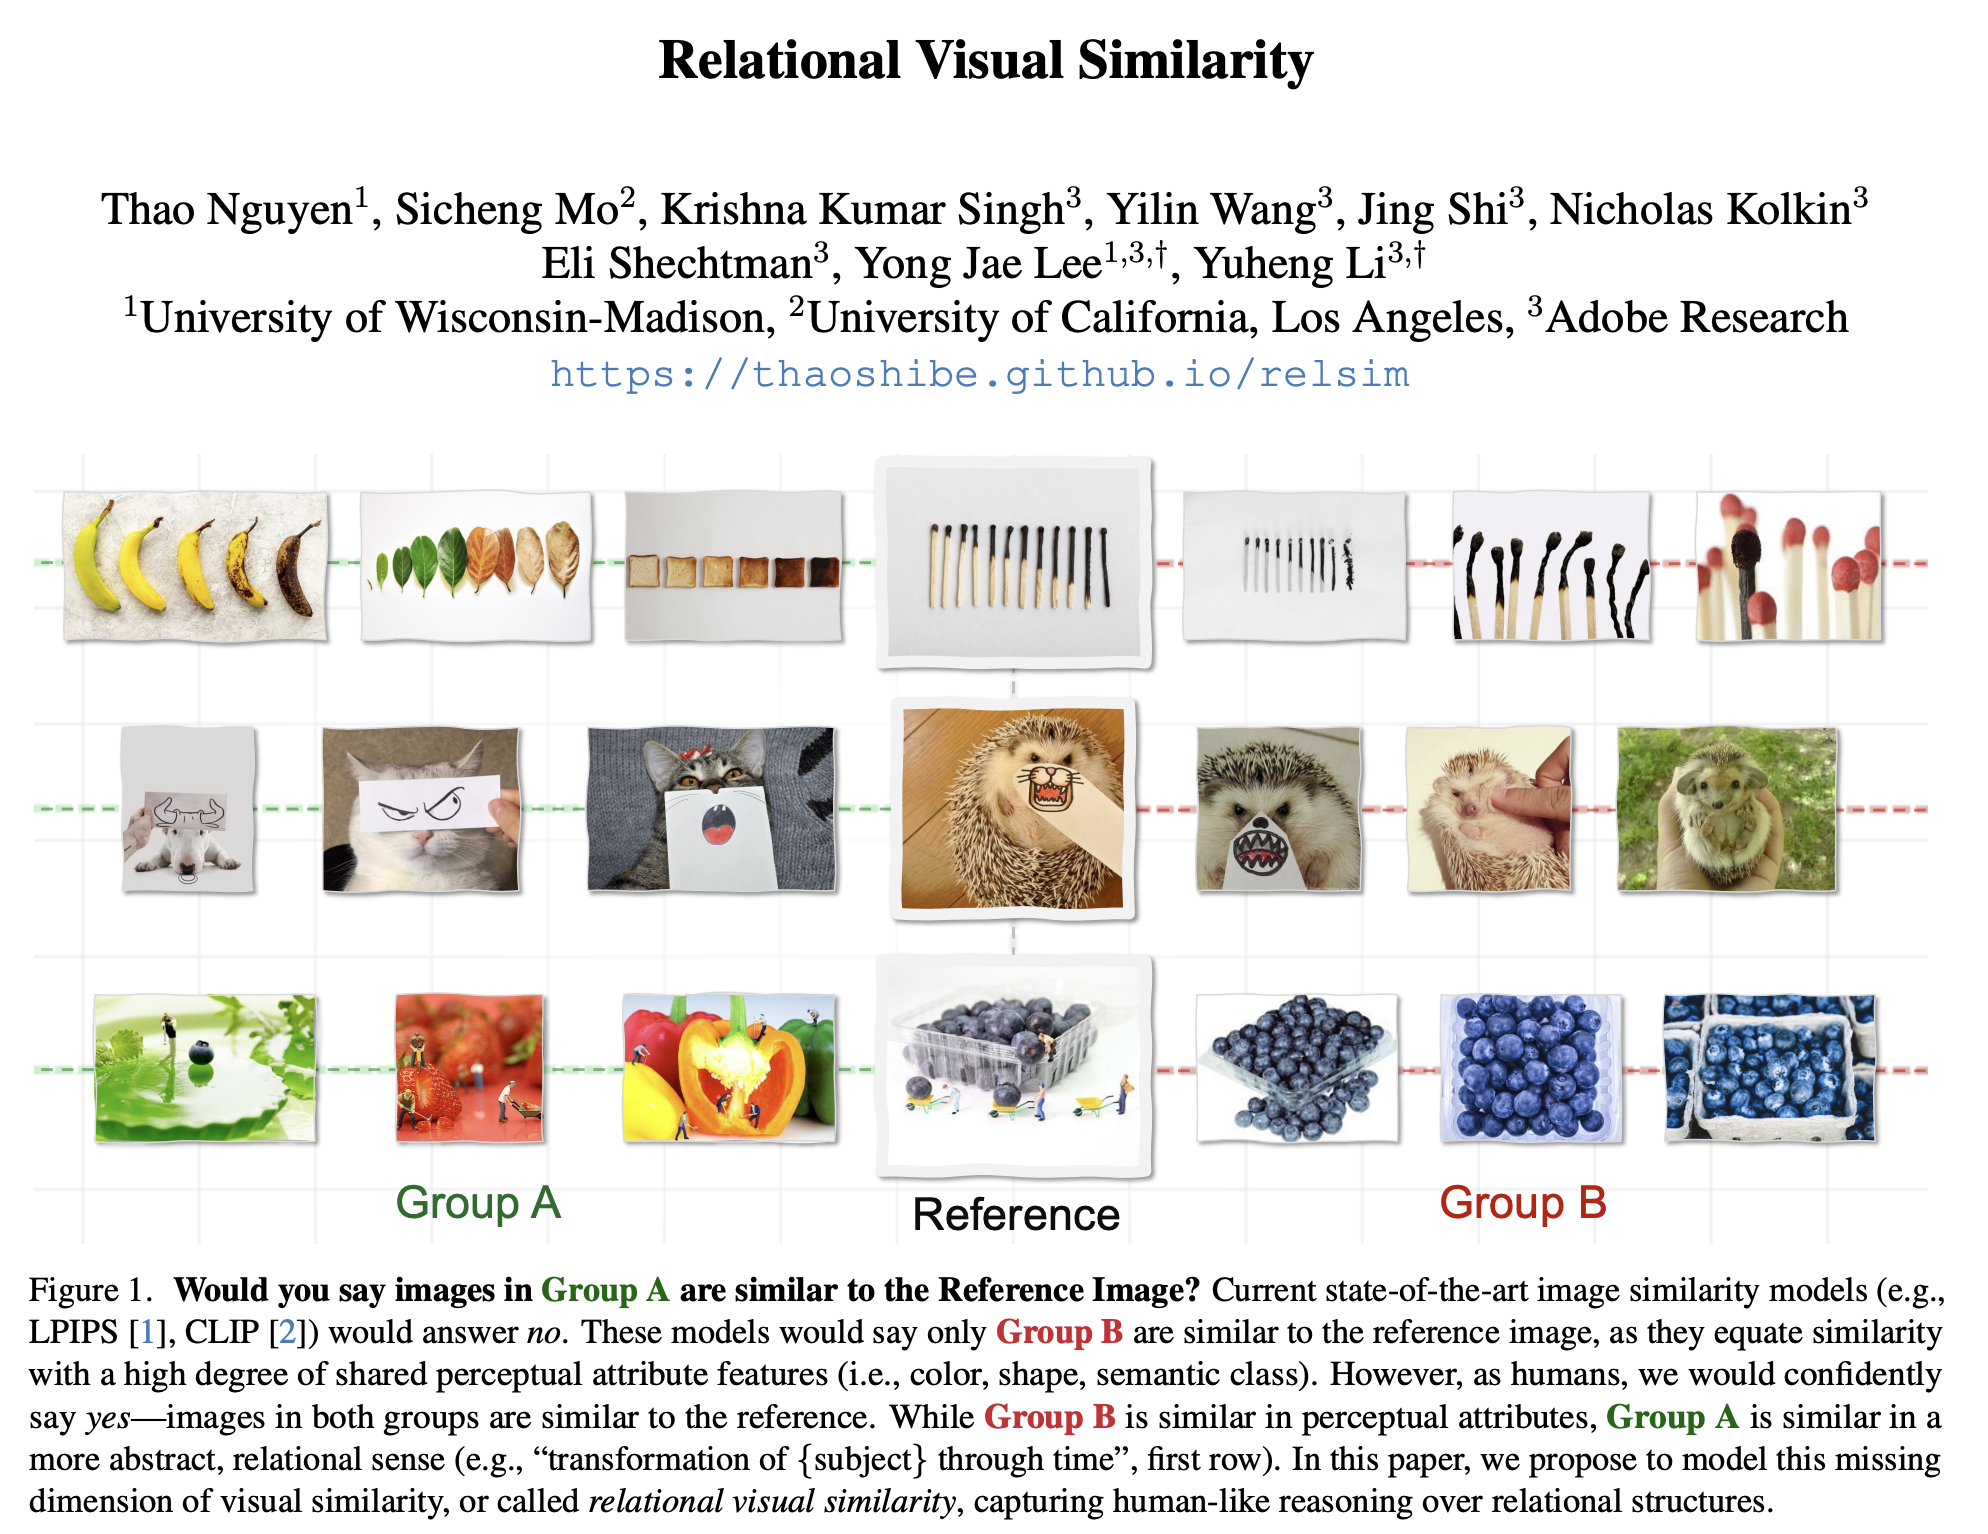
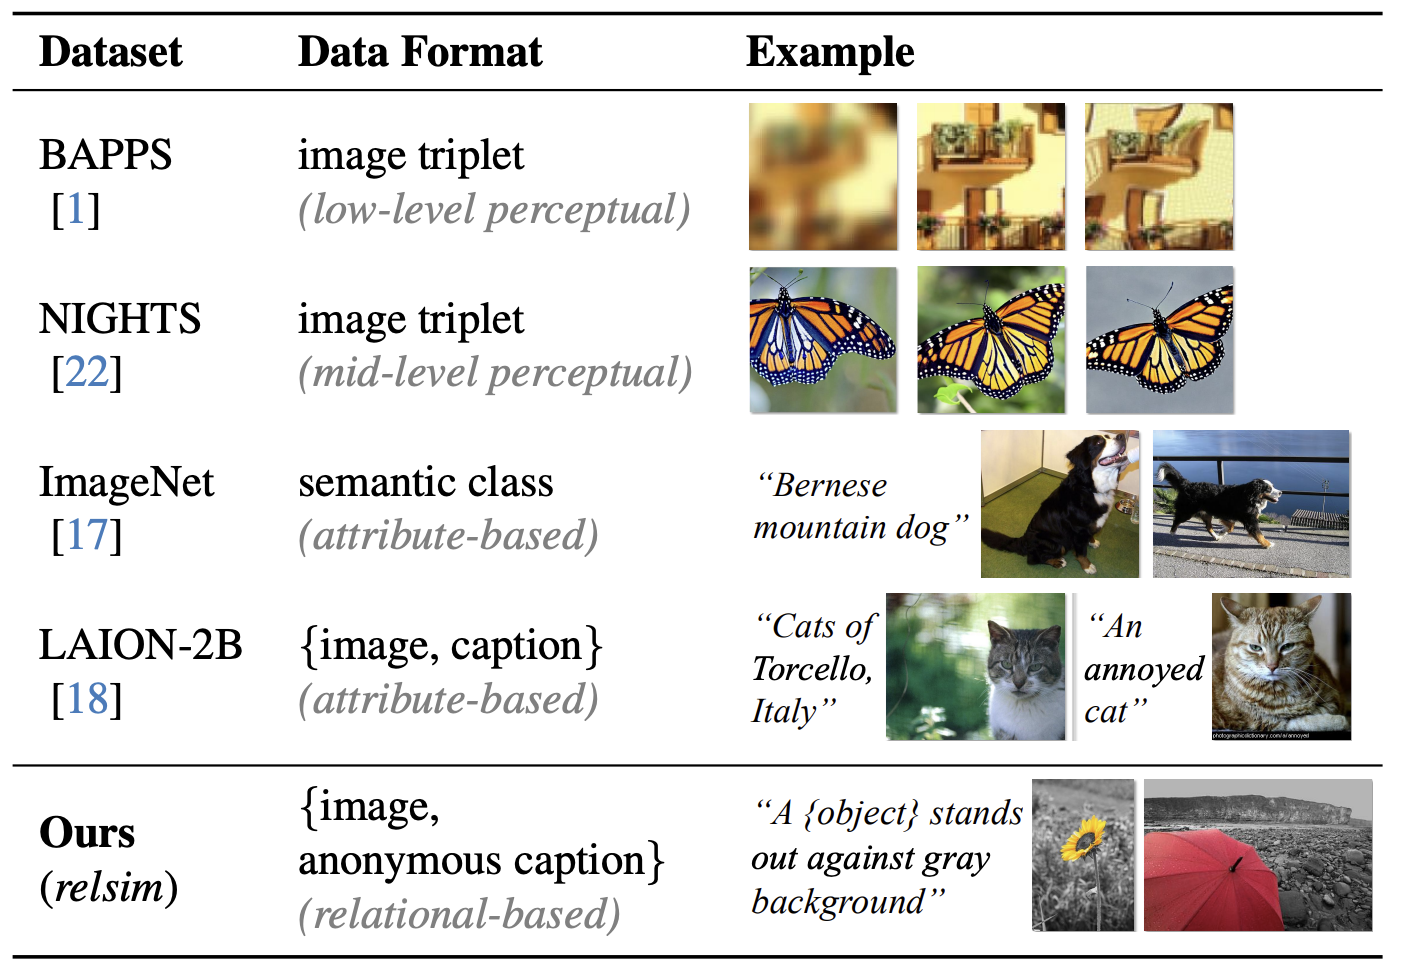
일반적인 인공지능의 Visual Similarity: 색상, 모양, 객체 종류와 같은 속성에만 치중 (Attribute Similarity)
- e.g., “파란색 성냥개비 더미” 사진과 “파란색 블루베리” 사진은 색상이나 형태적인 특징이 비슷하여 이를 유사하다고 판단하는 경향
그러나 인간은 Relational한 사고 또한 할 수 있음
- e.g., “성냥개비가 타들어가는 과정을 나열한 사진” / “바나나가 익어가는 과정을 나열한 사진”
- 두 이미지는 다른 색상, 형태를 가지지만 시간의 흐름에 따른 변형이라는 관계적인 논리가 동일 –> 이러한 유사한 논리의 공유를 인공지능 모델을 잘 잡아내지 못함
이같은 관계적인 구조를 측정할 수 있는 metric인 relsim을 제안
👫 Creating a Relational Dataset
두 이미지가 시각적으로 다르더라도 내재된 관계적 논리(Underlying relational logic)가 같다면 유사하다고 정의 → 이에대한 구현을 위해 Anonymous Caption 개념 도입
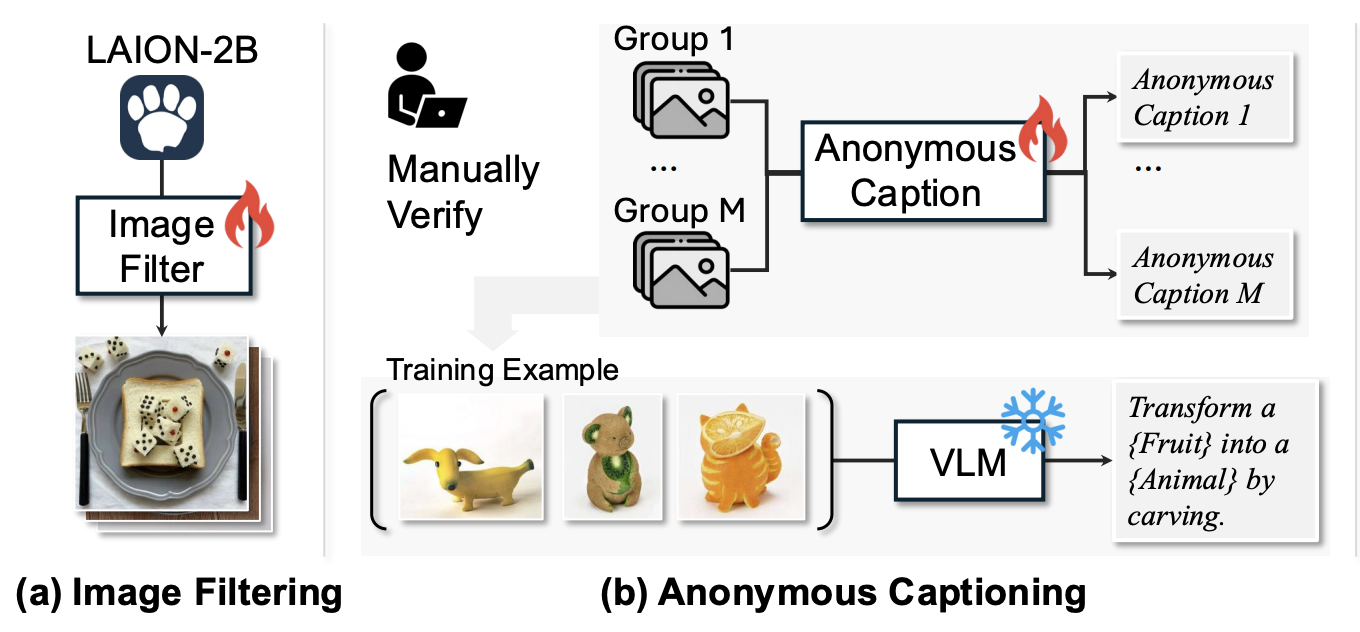
1. Image Filtering
- 대규모 데이터셋인 LAION-2B에서 관계적 구조나 논리를 포함할 가능성이 높은 흥미로운 이미지 선별
- 이를 위해 VLM(Qwen2.5-VL)을 fine-tuning 하여 이미지가 관계적 패턴을 가지고 있는지 (“Yes/NO”) 판별하여 114,000장(114k)의 관계적 이미지 확보
- VLM은 유의미한 이미지를 classify 할 수 있도록 대략 12,300장 (positive 1,300 / negative 11,000)의 예시를 human-labeled하여 데이터셋을 구축하고 모델을 fine-tuning
2. Anonymous Captions
이미지 한장을 보고 그 안의 추상적인 논리를 뽑아낸다는 것은 매우 어려움
동일한 논리를 공유하는 이미지 그룹을 활용
- e.g., “나비의 비행 과정” ↔ “사람의 달리기 과정” –> “어떤 대상이 점진적으로 움직이는 단계"라는 공통적 논리를 파악하기 쉬움
이같은 공유 이미지 그룹은 저자들이 직접 구축함 (532가지, 각 그룹별로 2~10장의 이미지)
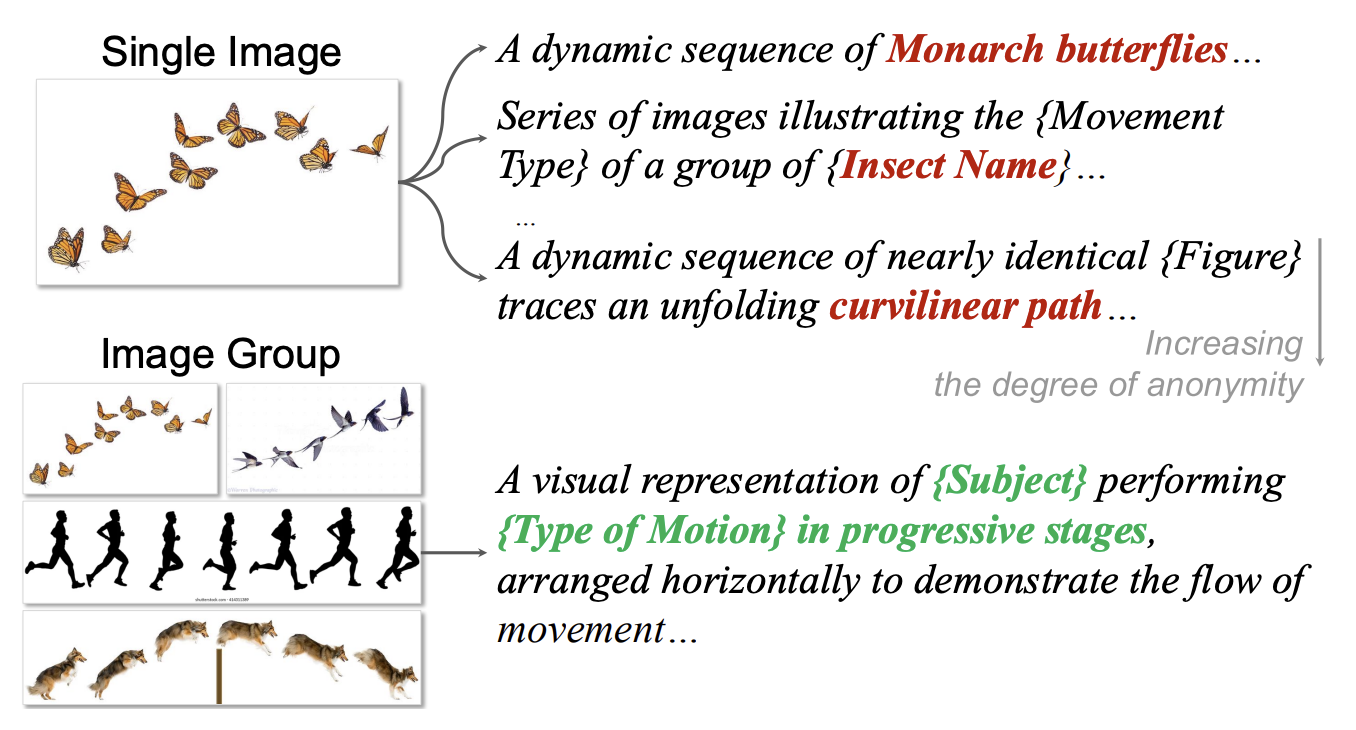
VLM에세 이 그룹을 보여주고 구체적인 객체의 이름등은
{subject}와 같은 placeholder로 대체한 Anonymous Caption을 생성- e.g., “A dynamic sequece of
{subject}traces an unfolding curvilinear path…”
- e.g., “A dynamic sequece of
이렇게 생성된 캡션은 해당 그룹의 모든 이미지와 쌍을 이룸
해당 데이터를 바탕으로 captioning model을 학습시킨 뒤, 앞서 필터링 한 114k 이미지 전체에 대해 anonymous caption을 생성하여 학습 데이터셋 ${I_i, A_i}^N_{i=1}$ 을 완성.
Captioning model이라 해서 clip 같은걸 사용한건 아니고 마찬가지로 Qwen-VL-7B을 사용. (아래 그림과 같음)
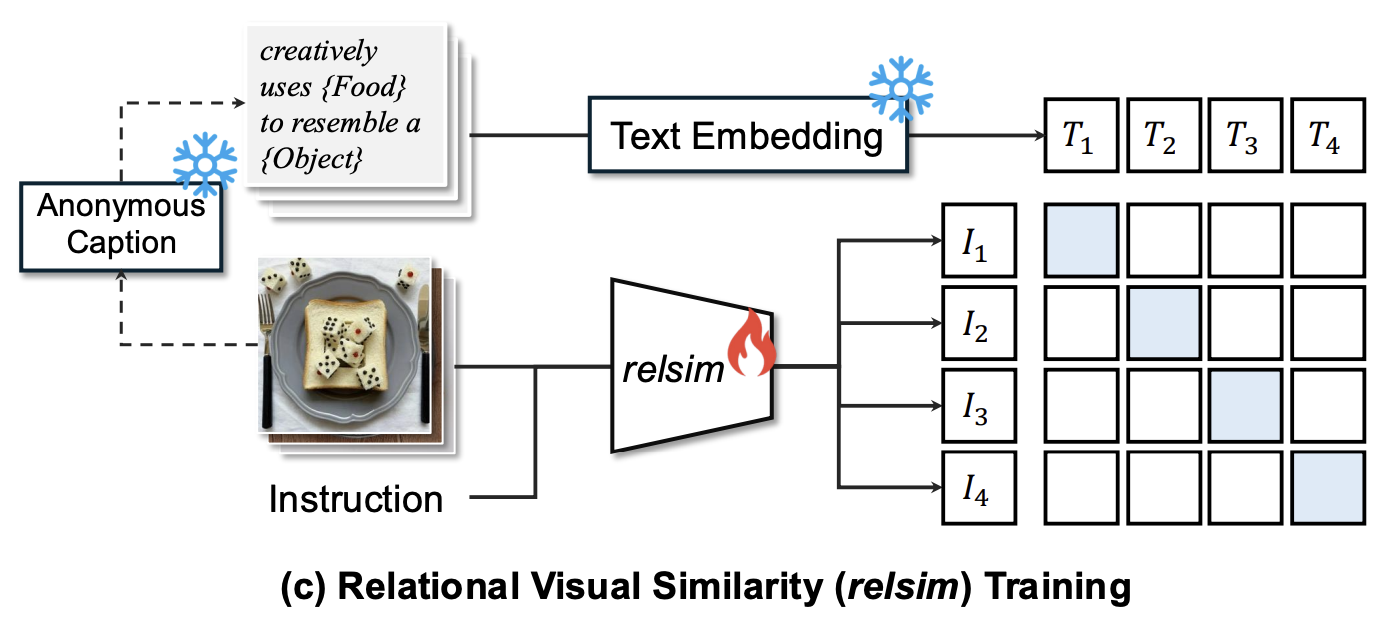
🏋 Relsim training
이미지($I$)와 Anonymous Caption($A$) 쌍이 준비되었으므로, 연결하는 모델을 학습
학습 목적: 이미지가 관계적으로 유사하다면, Anonymous Caption도 유사해야 한다
모델 구조:
Visual Exptractor ($f_V$):
- 단순 CLIP 등 이미지 인코더 만으로는 관계적 추론이 어려움
- World Knowledge를 가진 VLM(Qwen2.5-VL)을 사용
- VLM의 Vision Encoder만 가져와 사용하는게 아니라 전체 모델을 사용하며, text prompt 부분은 learnable query embedding을 사용 → 앞서 언급한것 처럼 CLIP등의 vision encoder 만으로는 관계적 유사성을 포착하기 어렵다 주장
Text Encoder ($f_T$):
- caption을 처리하는 부분
- pre-trained
all-MiniLM-L6-v2모델을 freeze하여 사용
이미지 $I$와 캡션 $A$의 embedding vector를 정규화 한뒤 dot product(내적)하여 유사도 점수 $s$를 계산
- $\tau$: leanable temperature scaling parameter
- Loss function: Contrastive learning에서 자주 사용되는 InfoNCE를 간단하게 사용.
이를 통해 $f_V$가 이미지의 시각적 속성보다 추상적인 relational structure를 캡쳐하는 특징을 추출하도록 함
🧑🔬 Experiments
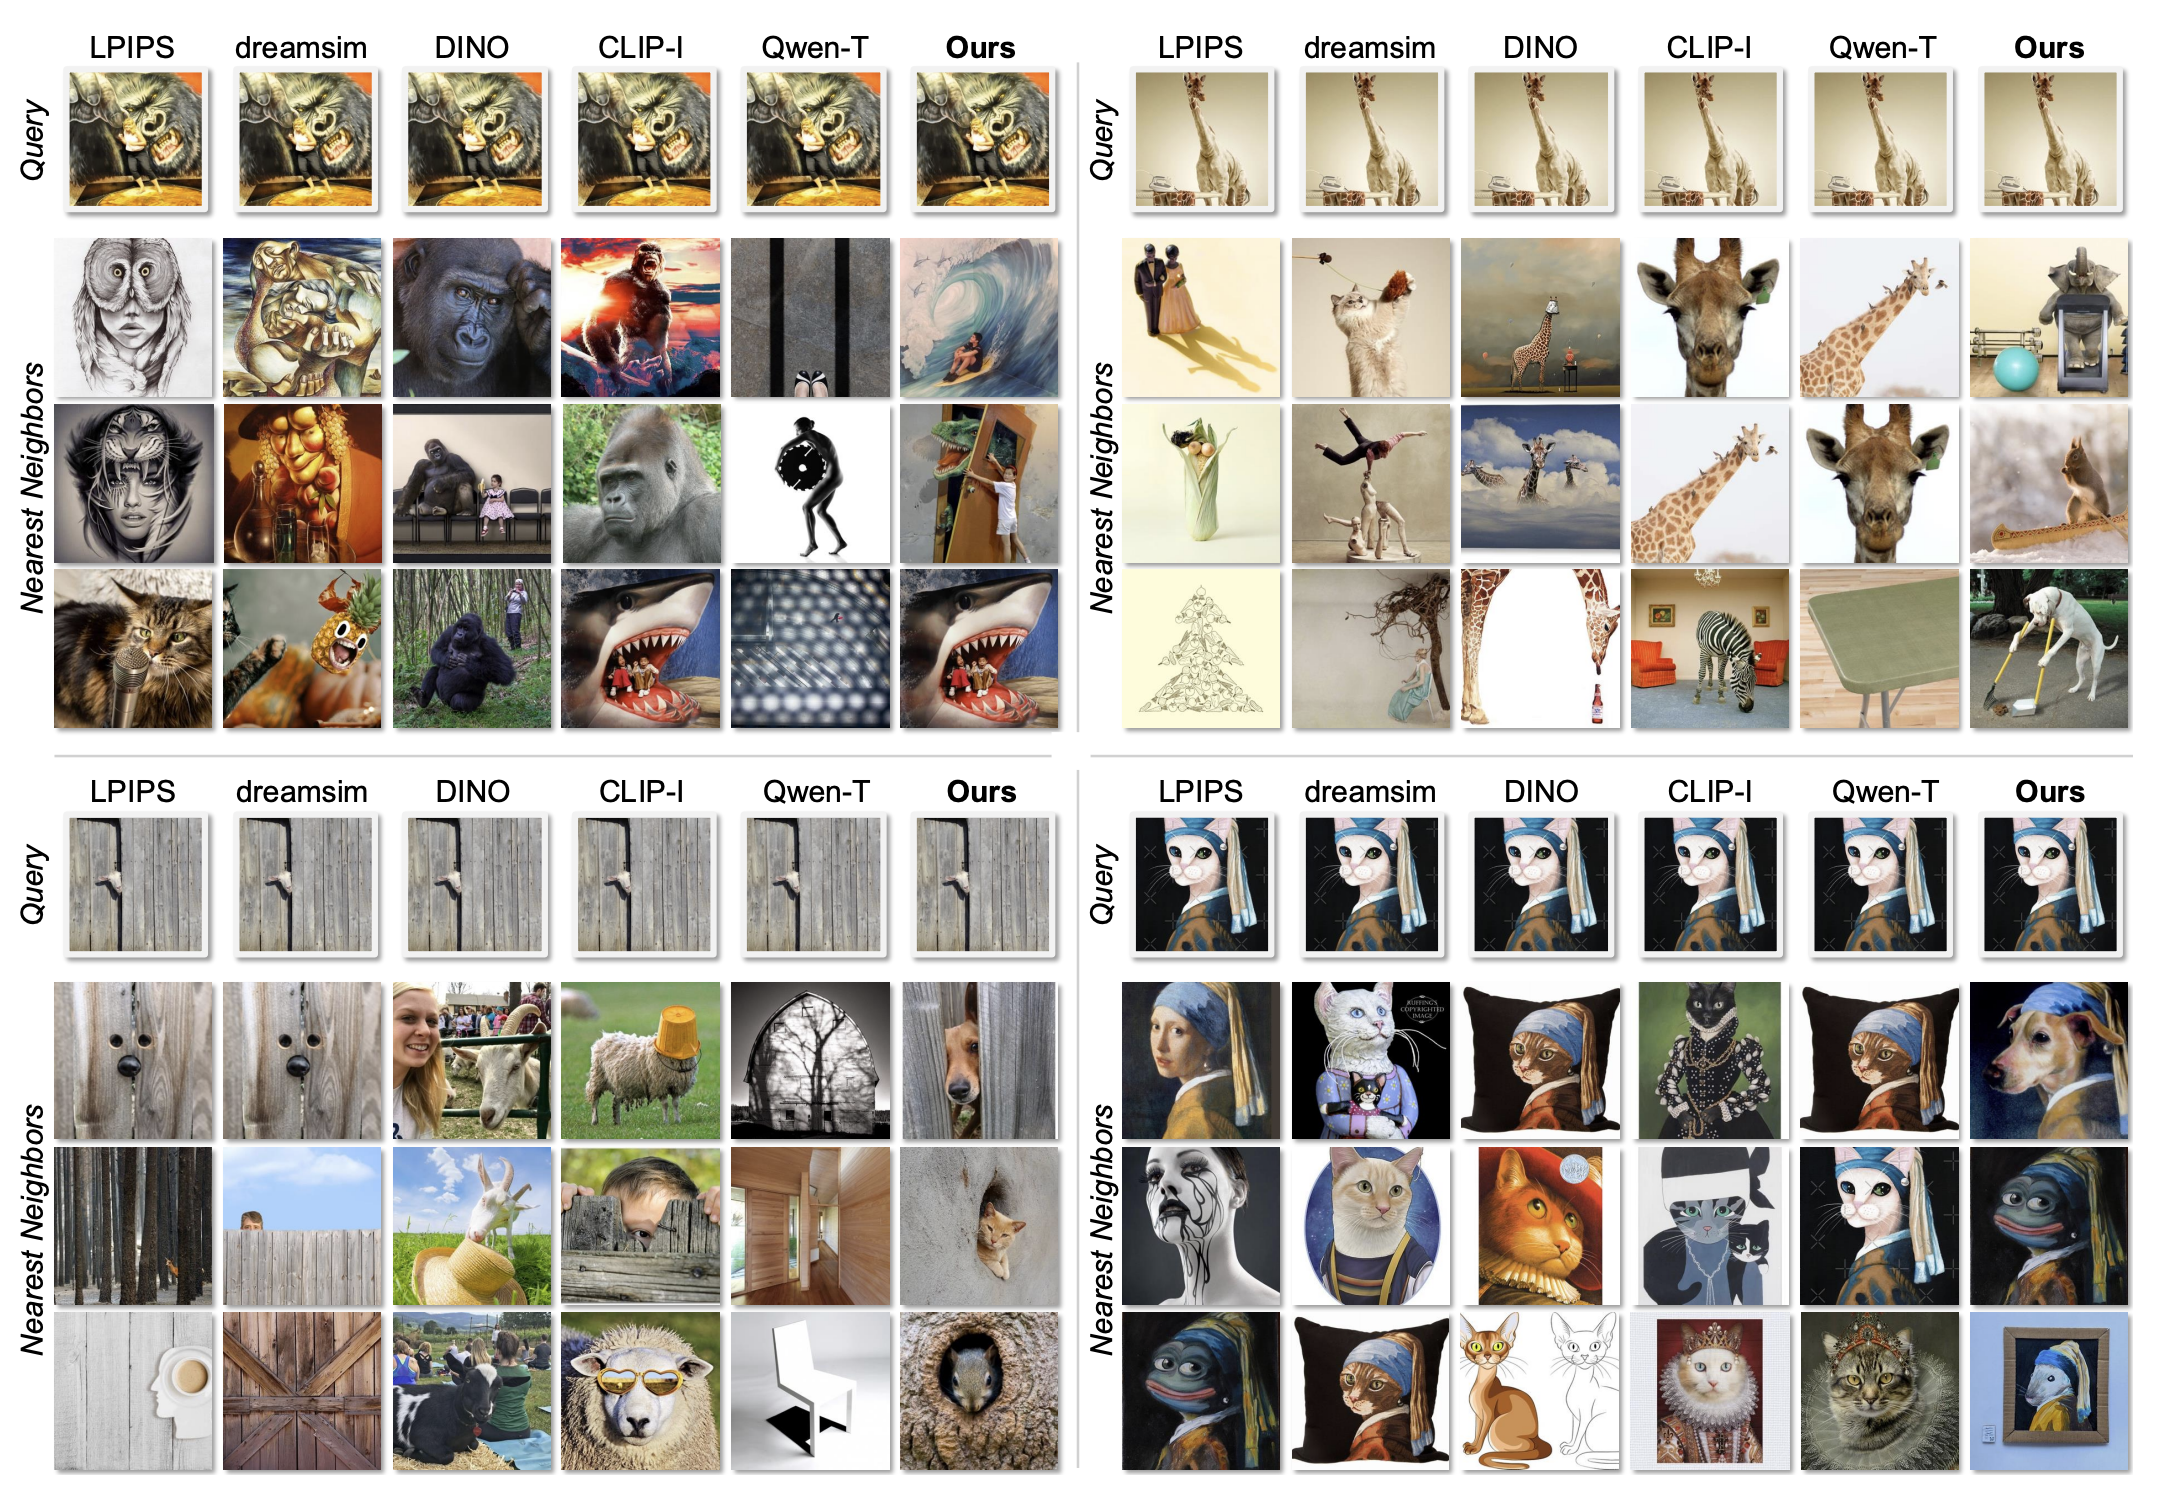
1. Image Retrieval
- 관계적 논리를 찾아내는 실험에서 비교군인 LPIPS, DINO, CLIP등 보다 훨씬 좋은 성능
- User study 결과 (사용자 평가) 관계적으로 유사하다는 평가
- 단순히 CLIP, DINO 등을 동일 데이터로 fine-tuning 하더라도 VLM 기반 relsim 보다 성능이 낮았음.
- 결론: 관계적 유사성 파악에 언어적 지식과 추론 능력이 필수적
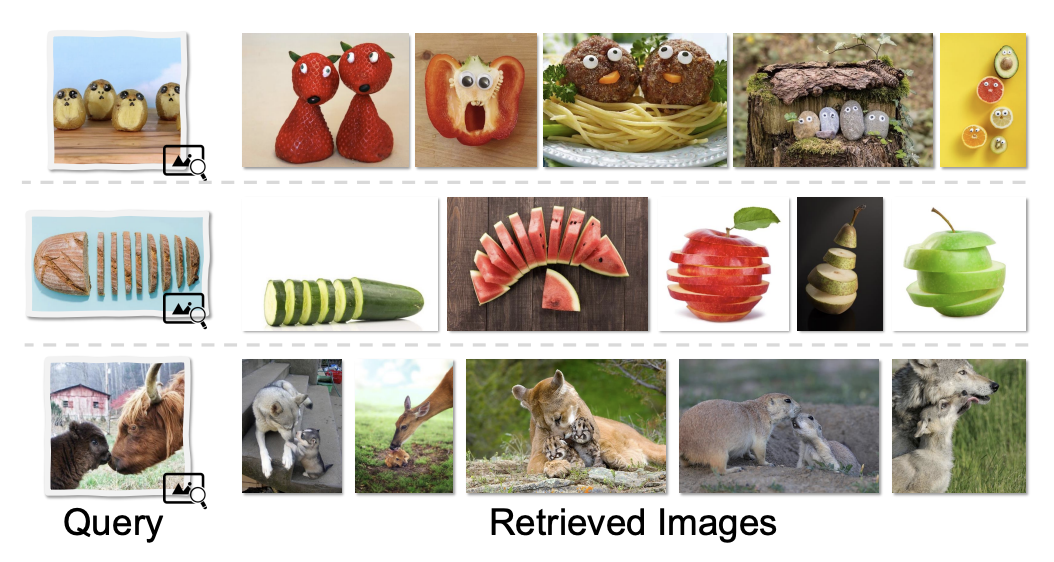
2. Analogical Image Generation
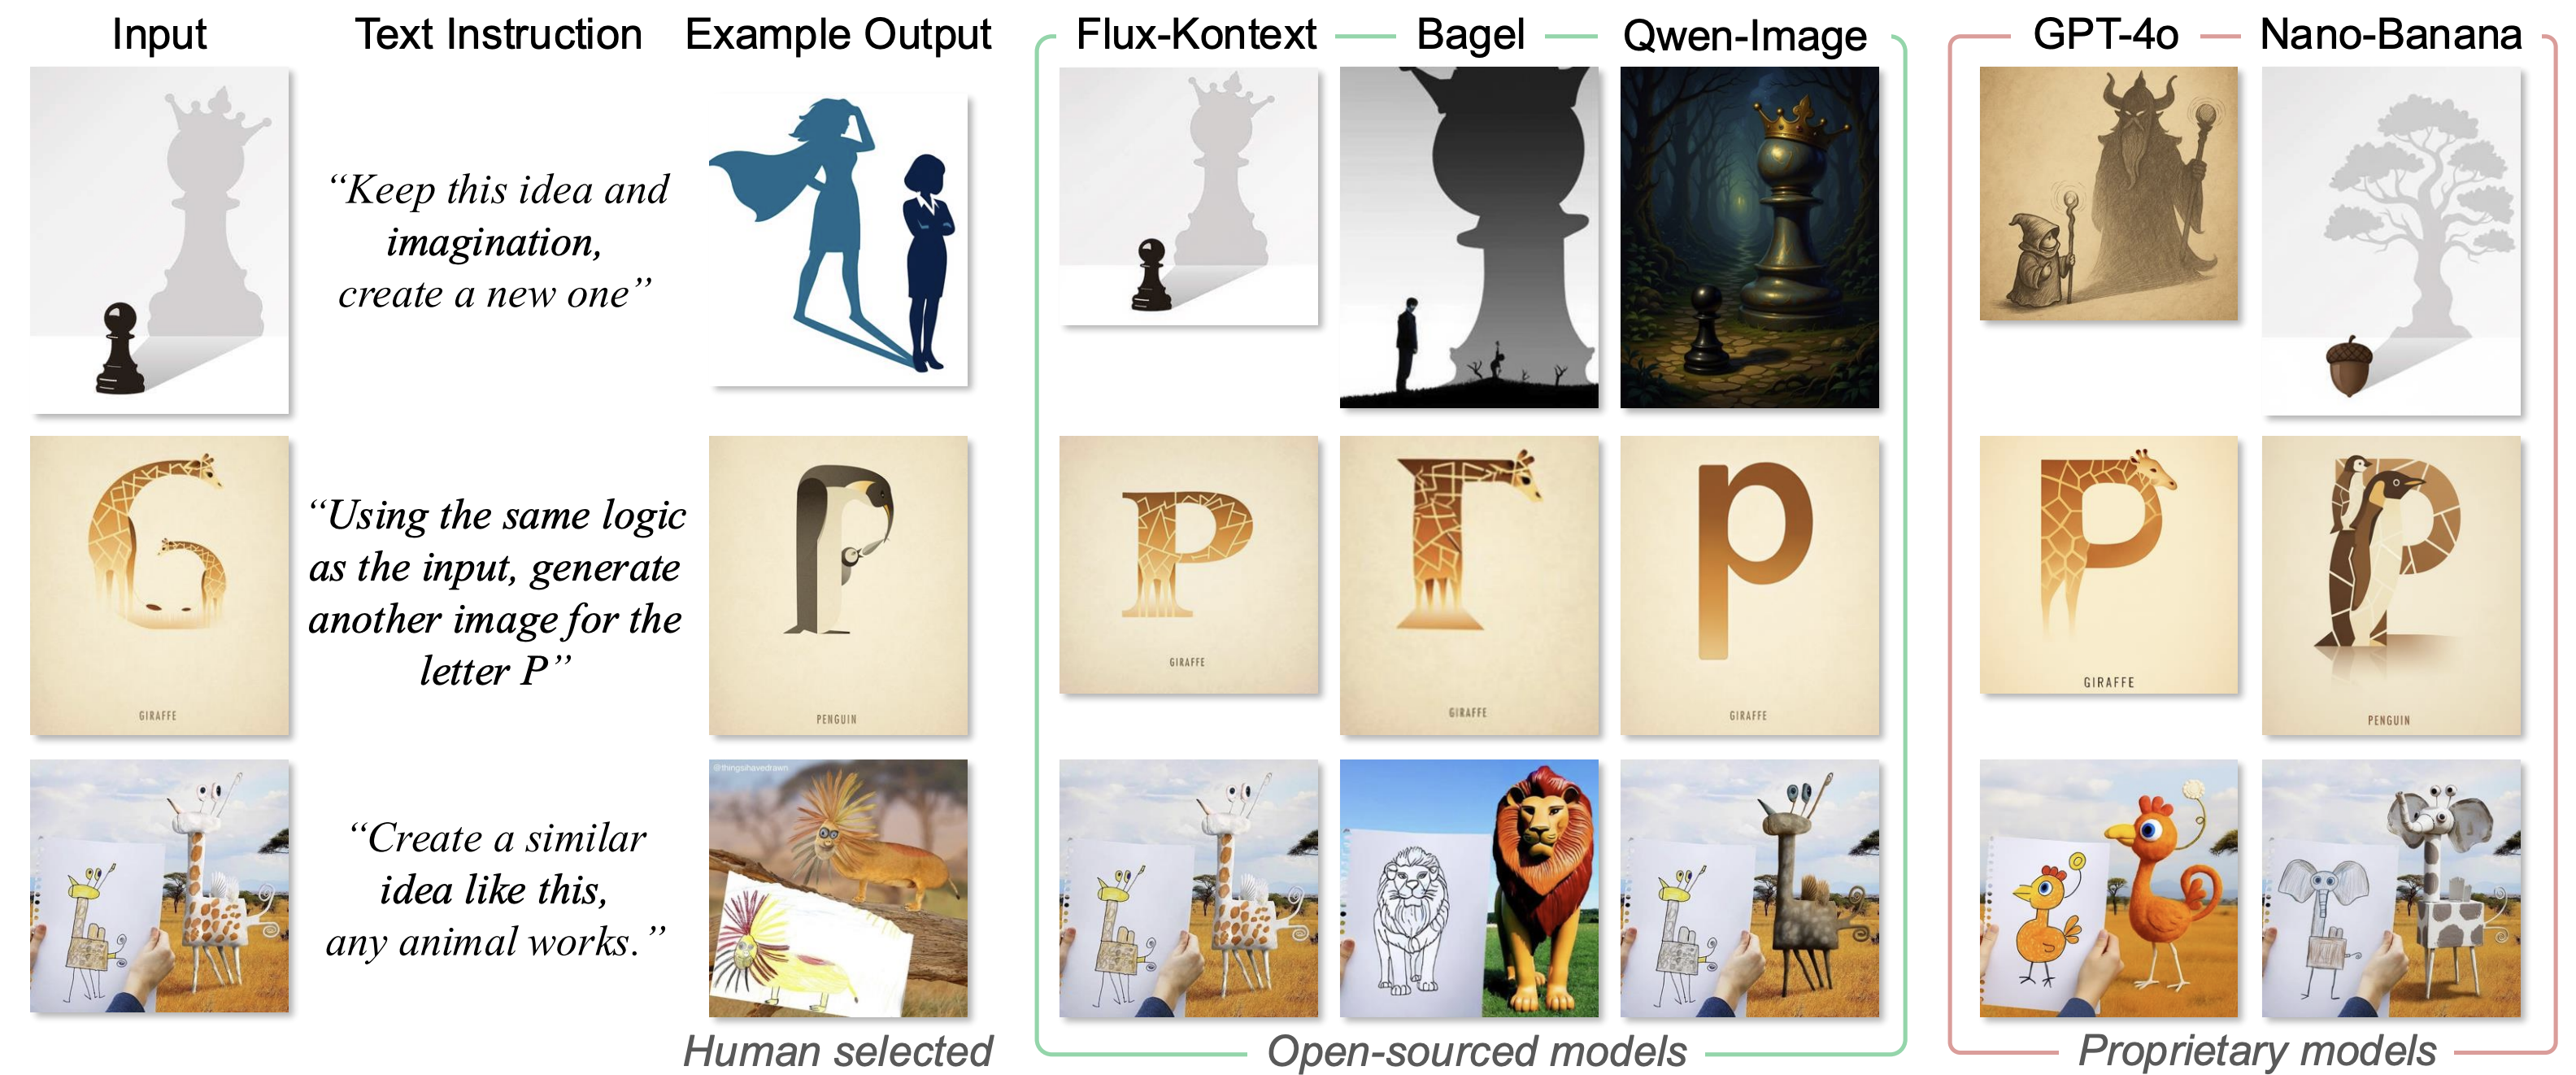
- 이미지 생성에서도 도움을 줄 수 있음을 시사
- 정확히 말하면 이미지 생성 모델에 연결한건 아니고, 이미지+텍스트 prompt를 통해 이미지를 생성할 때, relsim의 유사도를 사용자 의도(관계적 사고)를 잘 반영하는지에 대한 지표로 사용하였음
- 아래는 Analogical image generation의 예시